1-Quick Start
设计 限流系统要考虑的基本问题
RateLimiter可以是Server-Side也可以是Client-Side. 二者在设计上有所不同, 我们这里关注Server-Side的 限流架构 ;RateLimiter的功能应该足够灵活,支持各种规则的组合, 例如基于IP,UserID等等 ;RateLimiter设计的时候有2个大方向的选择:- 选择
library或者直接applicationCode的方式 - 选择 独立服务 的方式 ;
- 选择
sidecar的方式 ;
- 选择
RateLimiter触发限流的时候如何通知Users;- 非功能性质的考虑点:
- 必然意味着高并发 而且是分布式 的环境 ;
- 往往用的是分布式的内存, 尽可能优化空间 ;
- 容错能力 ;
一些常见的开源方案
- 在
TCP层做限流, 例如IptablesEbpf等技术, 使用 Iptables 规则做限流的小demo ; - 在
OpenResty或者Nginx的网关侧, 例如Apisix的 Traffic 插件 提供了limit-req,limit-conn,limit-count等等 ; - 如果打算 直接在
applicationCode或者 封装一个lib快速嵌入到自己的后端网关 , 可以考虑使用 封装redis的lua脚本- 推荐一个
github的demo, Scaling your API with rate limiters - 也推荐 一些库,语言相关, 例如
Java的 bucket4j
- 推荐一个
- 最推荐的思路还是使用
sidecar的姿势, 例如envoy的 ratelimiter - 如果不是云原生环境的, 可以考虑一些单独的服务设施, 例如 阿里的 Sentiel 即支持云原生, 也支持作为单独的服务 , 是一套比较成熟的防御体系
同时推荐:
- easegress 中还实现了 基于蓄水池抽样算法的 动态限流策略, 因为 给限流器定一个合适的 阈值才是真正的难点
2-RateLimit algorithm
有2个基本的实现思路
- Counter Based: 使用计数器的思路
- 这种方法通常以某个固定的时间窗口为基础,计算在这个时间窗口内的请求数量。当请求数达到一定限制时,新的请求会被拒绝或者延迟处理
- Queue Based: 使用队列的思路
- 这种方法将所有的请求存储在一个队列中,并以一定的规则从队列中取出请求进行处理。当队列满时,新的请求会被拒绝或者延迟处理
2-1 Leaking Bucket

漏桶算法:
- 使用队列的思路去理解, 请求来了放到队列中,然后消费者按照
Fixed Rate去消费, 队列满了意味着 触发限流 ;
Notes
个人理解可以用 计数器或者 队列实现, 我个人偏好计数器
使用队列实现的话:
- 内存消耗就是队列大小, 可控.
- 简单
使用计数器实现的优点:
- 基本不消耗内存 ;
基于 Counter-Based 的漏桶算法伪代码实现:
import time

class LeakyBucket:
    def __init__(self, leak_rate, capacity):
        # 确定’漏洞‘的固定流失速率
        self.leak_rate = leak_rate
        # 桶的容量
        self.capacity = capacity
        # 桶中当前的水量
        self.water = 0
        # 最后一次检查桶的时间
        self.last_check = time.time()

    def pour(self, amount):
        # 检查桶中的水量,并更新桶中的水
        self.drip()
        if amount + self.water > self.capacity:
            #  如果加入的水+现有的水超过容量,返回 False
            return False
        else:
            self.water += amount
            return True

    def drip(self):
        # 计算自上次检查以来‘漏去‘了多少‘水‘
        now = time.time()
        leakage = (now - self.last_check) * self.leak_rate

        # 更新桶中的水量和最后检查时间
        self.water = max(0, self.water - leakage)
        self.last_check = now
不管使用哪种算法, 我理解:
- 漏桶都不能解决突发流量的问题, 他的特点就是实现简单而且 消耗令牌的速度是 匀速速度
- 但是由于其速度 匀速的特点, 能很好的进行 流量整形
2-2 Token bucket
令牌桶的思路也比较简单,我往队列(桶)中 按照一定的速度添加令牌. 这样:
- 压力小的时候积累
- 压力大的消耗
能支持突发的流量.
一个简单的伪代码如下:
import time

class TokenBucket:
    def __init__(self, rate, capacity):
        self.rate = rate  # Token fill rate in tokens per second
        self.capacity = capacity  # Maximum tokens in the bucket
        self.tokens = capacity
        self.last_refresh_time = time.time()

    def consume(self, tokens):
        if tokens > self.capacity:
            return False  # Can't consume more tokens than bucket capacity

        self.refresh()

        if tokens > self.tokens:
            return False  # Not sufficient tokens
        else:
            self.tokens -= tokens
            return True

    def refresh(self):
        now = time.time()
        time_since_last = now - self.last_refresh_time
        refill = time_since_last * self.rate
        self.tokens = min(self.capacity, self.tokens + refill)
        self.last_refresh_time = now
代码的思路如下:
- 有2个主要的东西需要记录:
- 当前的令牌数
- 最后一次添加令牌的时间
- 当新请求来消耗令牌的时候:
- 根据流入速率计算桶中应有的令牌数量,然后对比该数量和请求需要消耗的数量
下图来自 BytebyteGo!

2-3 Sliding Window Log
Note
Fixed Window 的限流太简单,在
Redis In Action中有详细的描述,这里不做任何分析,特点就是简单
这个思路就更简单了, 能实现各种的复杂限流请求.
因为 是滑动窗口的 Log 会记录每一次请求的时间放到一个队列中, 例如 Redis 的 Zset .
- 简单,但是由于记录了每个事件的行为,所以我们可以很灵活.
- 可以控制
- 空间占用会大
- 算法也不高效,需要有策略删除掉过期数据
2-4 Sliding Window Counter
同样是滑动窗口的算法, 这个算法用的是近似的思路. 用来避免上面的 内存 和 性能 问题。
如果一直持续在高并发的场景中,我们可以做一个近似的假设,用最近的一个窗口去猜测后续的压力.
举个例子说限流算法允许 7/min .
- 前
1min内有5个请求 - 当前 的
min有 3个请求, 当前 时间戳位于 当前窗口的30%, 那么使用 近似算法
我们预估当前的是:
- 当前窗口的请求数 + (前面窗口的请求数 * (1 - 当前时间戳位于当前窗口的百分比))
我们预估是 6个请求 < 7个, 如果大了就 触发限流.
下面来自 BytebyteGo!

3-Go Deeper
下面讨论一些更深入的问题.
3-1 Dynamic Rate Limiting Based On R-T
一个非常 困难的问题是如何去设置一个确定的限流值.
以下内容来自于 酷壳
如何去设置一个合适的值,这个基于 历史的 Metrcis 或者 基准性能测试得到系统的承受能力 .
静态 → 动态 是很常见的思路
Jvm虚拟机本身的优化技术Jvm美团做的 简单动态线程池 dynamic-tp
给每个业务做性能测试 定制 阈值的思路, 成本很高 , 因为从需求本身来看就是动态的:
- 同一个服务依赖数据库, 每个时间段的数据库压力是不同的, 数据量也在一直增加 等等 导致 服务的
qps能力是动态的 ; - 不同的服务之间的
API更是不同 ; k8s的服务本身有自动处理伸缩的动态特性, 所以 也是动态的 ;
从
TCP拥塞学到的动态流控
TCP使用RTT: Round trip time 来探测网络的延时和性能, 从而设定相应的 滑动窗口大小, 实现流控
我们可以借鉴用来 基于 RT: Response Time 的统计值来动态的流控.
设计要点
- 统计的成本很高, 尤其是 p90 p99 这种, 尤其是在分布式的环境下, 可以参考 promethus 的统计思路 ;
- 统计的 算法层面要取样, Reservoir Sampling, 编程珠玑的算法 ;
- 控制的算法可以参考 TCP 的哪些破事 的思路:
- 拥塞控制,发送方接收到3个一样的
ack就认为是丢包, 那么我们 定义如果p90/p99变慢事件 - 同样的,太慢了,流控
QPS减半,OK的话进入慢启动流程, 直到变慢. - 从全局看,整个限流的 的动态值 最后会在一个值上下震动, 如果 k8s 扩容, 这个值会动态自动动态的增加
- 拥塞控制,发送方接收到3个一样的
在 耗子叔的创业项目 easegress 实现了这个算法 , 强烈推荐阅读源码 ;
3-2 Rate Limit Rules
如果是 Envovy 网关 或者 sentitial 这样参数,都会考虑 设计一个 规则引擎的思路,把规则和实现解耦,提供一个 统一的入口, 在自己设计 限流库或者组件的时候也可以考虑:
domain: messaging
descriptors:
  - key: message_type
    value: marketing
    rate_limit:
      unit: day
      requests_per_unit: 5
或者
domain: auth
descriptors:
  - key: auth_type
    value: login
    rate_limit:
      unit: minute
      requests_per_unit: 5
自己封装服务可以参考 BytebyteGo 的设计图.
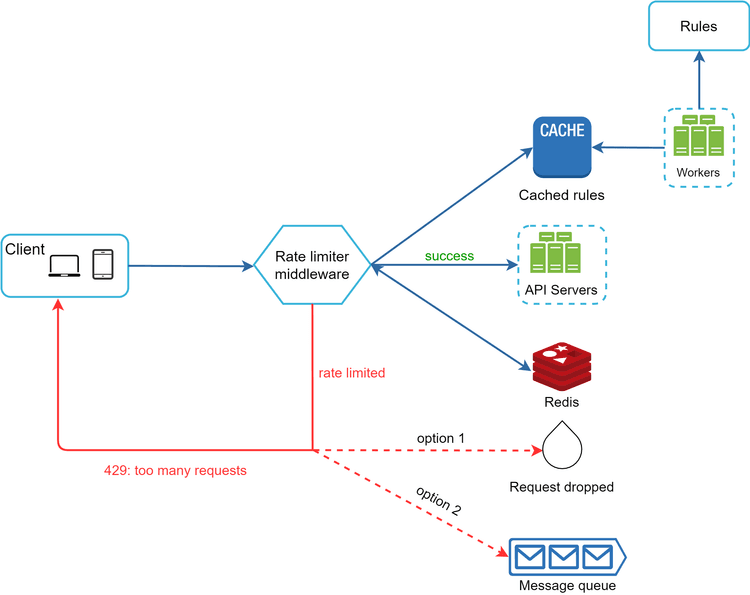
3-3 More with Http 429
除了通用的 httpStatus = 429 之外, 还有一些更通用的 Header 可以考虑借鉴:
X-Ratelimit-Remaining: 在当前的时间窗口内,允许的剩余请求次数 ;X-Ratelimit-Limit: 在时间窗口内可以发出的最大请求次数 ;X-Ratelimit-Retry-After: 客户端需要等待多少 秒, 然后才能再次发出请求而不是被限速 ;
3-4 Distributed Env
用 Redis + Lua 是解决 分布式环境中的 Race Condition 问题的简单方案, 如果是 Sticky Session 的设计或者自研, 需要自己用乐观锁 或者类似的思路来规避这个问题 .
下图来自 ByteByteGo

3-5 What’s More ?
- 限流触发的 策略一般需要考虑
SoftVsHard:- Hard : The number of the requests can not exceed the threshold ;
- Soft: Requests can exceed the threshold for a short period ;
- 客户端设计 在
RateLimit中非常重要, 考虑 辅助其他的弹性设计,例如熔断,隔离 降级 等来 规避一直触发限流 ; - 限流组件 跟大多数一样,在架构 越早期的 考虑越好 ;
- 限流组件要有兜底,要有手动开关
- 一定要有 监控组件
- 如果是自己实现: 可以考虑先提供先简单实现, 比如说 漏桶,
Fixed-Window, 然后再考虑 滑动计数 和 令牌桶
Refer
- Design-A-RateLimiter
- Manage Traffic and load in Google Cloud : google 云技术 blog,教你如何 限制流量 ;
- Twitter-Rate Limits V1.1:
Twiiter官方的api流控规范 ; - Google Cloud-rate limit handle :
Google Cloud在处理RT异常发生的时候你如何根据 算法去重试 ; - IBM microservices:
IBM微服务,其中有部分限流相关的文档 - AWS-Throttle API requests for better throughput:
aws流控文档 - BLOG-Stripe rate limiters: 私人博客,关于
RateLimiter - Shopify-API rate limit : 虾皮官方的
RateLimiter - Better Rate Limiting With Redis Sorted Sets : 2015 年的 博客, 使用
Redis的SortedSet实现更好的限流算法 - System Design-Rate Limiter and data modeling : 2018 年的 博客,
RateLimiter和 数据模型 - How we built rate limiting capable of scaling to millions of domains : 2017 年的博客, 如何在 百万级别的
domains中设计RateLimiter; - Lyft-Ratelimit :
lyft搞的 限流边车,目前给了envoyProxy? - Scaling Your Api with rate limiters : 一个 包含了 大量
lua+redis源码实现的 博客, 推荐 - What-is-edge-computing :
cloudflare的好文章, 什么是边缘计算 ; - Rate limit with IpTables : 一个小
demo, 使用iptables在 3层网络上实现了 限流 ;- 如果不理解,这一在那一层,可以看 wiki-osi-model